MmaDA-VLA: Um Modelo Revolucionário para Visão, Língua e Ação
A Inteligência Artificial (IA) tem sido uma área em constante evolução, com novos avanços sendo feitos regularmente. Uma das áreas que têm gerado grande interesse nos últimos anos é a combinação de visão, língua e ação, ou seja, a capacidade do modelo de processar imagens, entender o significado da linguagem associada a essas imagens e realizar ações baseadas nessa compreensão. Nesse contexto, um dos modelos mais recentes que têm chocado a comunidade científica é o MmaDA-VLA.
O Que é MmaDA-VLA?
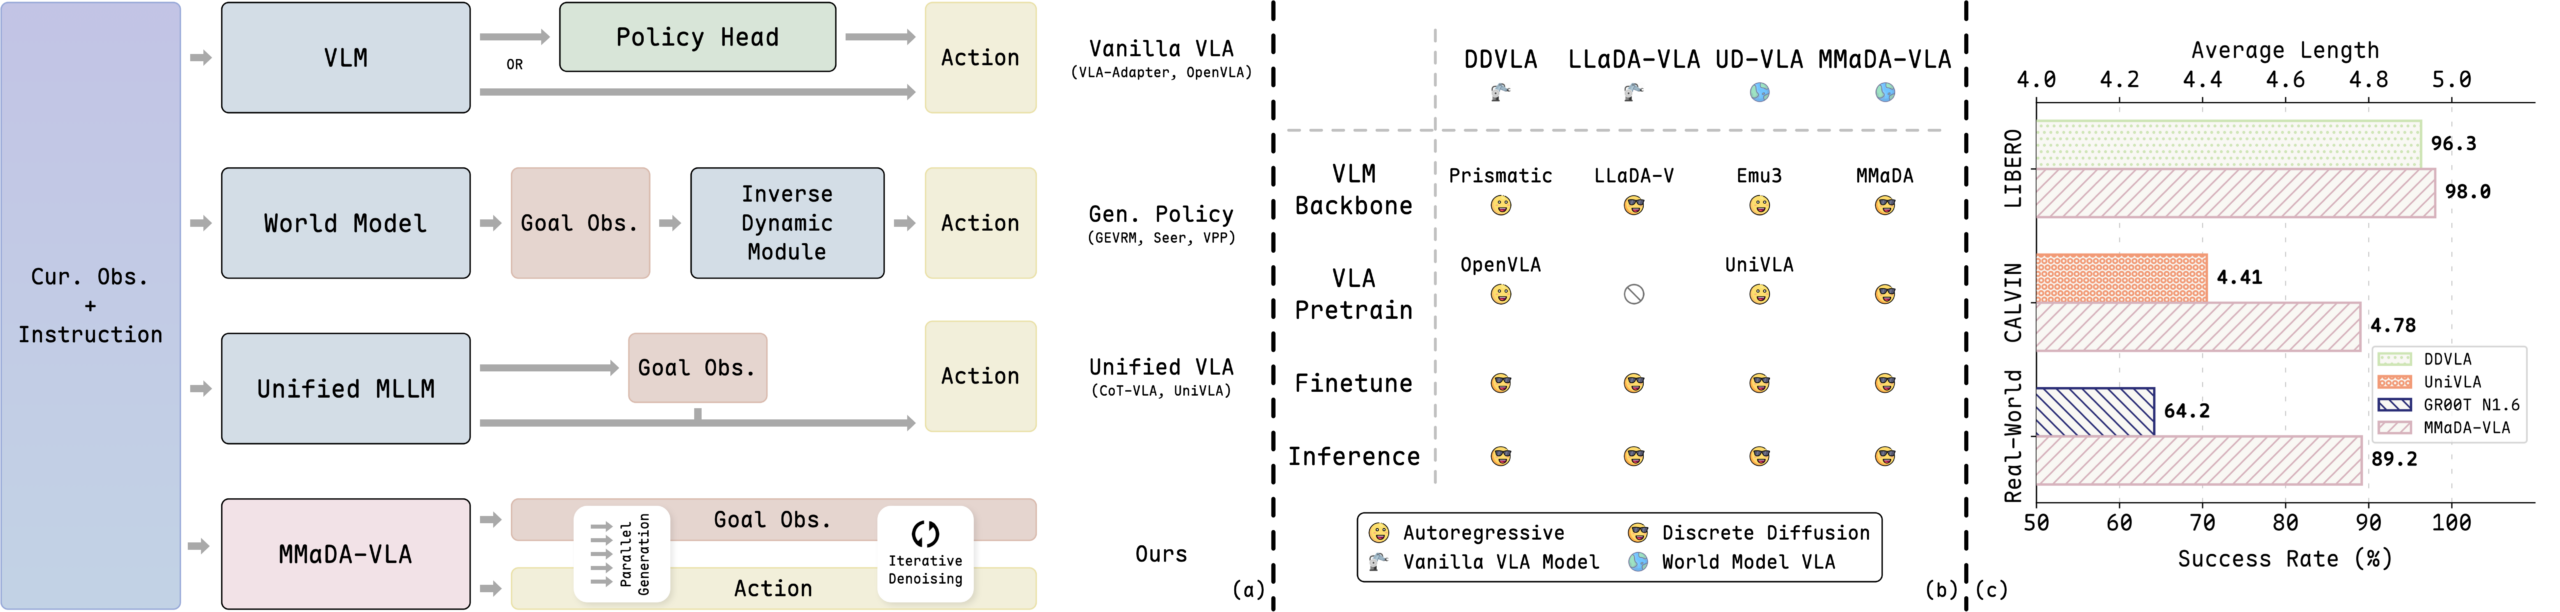
O MmaDA-VLA (Large Diffusion Vision-Language-Action Model) é um modelo de IA desenvolvido com o objetivo de combinar visão, língua e ação em uma única estrutura. Ele utiliza como backbone o MMaDA-8B-Base, um modelo de linguagem diferencial unificado que permite à IA processar e entender imagens, textos e ações de forma mais eficiente.
Como Funciona o MmaDA-VLA?
O funcionamento do MmaDA-VLA é bastante complexo e envolve várias etapas. Em resumo, o modelo pode ser descrito da seguinte maneira:
- Pre-processamento: As imagens de visão são coletadas tanto das câmeras de terceira pessoa quanto do ângulo do pulso (wrist-view). Essas imagens são então concatenadas verticalmente e resizadas para uma resolução de 256 × 256 pixels.
- Modelo de Linguagem Diferencial Unificado: O MMaDA-8B-Base é um modelo de linguagem diferencial unificado que utiliza técnicas de aprendizado de máquina (ML) para processar e entender o significado das palavras associadas às imagens. Isso permite ao modelo aprender a representar conceitos complexos em forma de código binário.
- Processamento de Ações: Com base nas ações apresentadas, o modelo pode executá-las de acordo com a compreensão obteida através do modelo de linguagem diferencial unificado.
Por que Importa o MmaDA-VLA?
O MmaDA-VLA tem potencial revolucionário no campo da Inteligência Artificial, pois permite à IA:
- Aprendizado de Tarefas mais Complexas: Ao combinar visão, língua e ação, o modelo pode aprender tarefas mais complexas do que qualquer um desses componentes isoladamente.
- Aplicabilidade em Domínios Vários: O MmaDA-VLA tem potencial para ser aplicado em uma variedade de domínios, incluindo assistência virtual, controle remoto e análise de dados.
Exemplos e Analogias
Para entender melhor como o MmaDA-VLA funciona, podemos considerar alguns exemplos:
- Assistente Virtual: Imagine um assistente virtual que não só pode processar palavras, mas também detectar objetos na imagem. Isso seria possível com o MmaDA-VLA.
- Controle Remoto: O modelo poderia ser usado para controlar dispositivos remotamente com base no que está sendo observado.
### Tecnologia em Ação
A tecnologia de IA tem sido cada vez mais avançada e é importante seguir os desenvolvimentos como essa para entender melhor o potencial ela oferece, além de explorá-la em seus diversos usos.
Conclusão
O MmaDA-VLA representa um marco importante na Inteligência Artificial. Com sua capacidade de combinar visão, língua e ação em uma única estrutura, ele tem o potencial de revolucionar vários domínios. Embora o desenvolvimento de modelos de IA seja complexo, entender como eles funcionam é crucial para explorá-los em seus diversos usos.