Large Language Models: Uma Visão Geral das Arquiteturas Fundacionais
Introdução
Os modelos de língua grande (Large Language Models, LLMs) têm revolucionado o processo de processamento de linguagem natural, permitindo que as máquinas aprendam a entender e gerar texto com precisão semelhante à humana. No entanto, esses modelos enfrentam desafios significativos relacionados à escalabilidade, implicações éticas e diversidade de aplicações. Neste artigo, vamos explorar recentes desenvolvimentos em arquiteturas LLMs e métodos de treinamento, propôndo uma nova taxonomia que categoriza essas modelos com base na escalabilidade, domínios de aplicação e implicações éticas.
O que são Modelos de Linguagem Grande?
Os Modelos de Linguagem Grande são um tipo de inteligência artificial conhecido por sua capacidade de processar grandes quantidades de texto e aprender padrões complexos. Eles se baseiam em redes neurais convolucionais com atenção (Transformers) e são treinados em grandes conjuntos de dados, como livros, artigos e documentos.
Como Funcionam os Modelos de Linguagem Grande?
Os LLMs funcionam da seguinte maneira:
1. Treinamento: Os modelos são treinados em grandes conjuntos de dados, onde aprendem a entender padrões e estruturas na linguagem.
2. Processamento: Uma vez treinado, o modelo é capaz de processar texto novo e gerar respostas coerentes.
3. Aprendizado: Os modelos continuam a aprender e se adaptar ao tempo, melhorando sua precisão e compreensão da linguagem.
Desafios dos Modelos de Linguagem Grande
Os LLMs enfrentam vários desafios, incluindo:
- Escalabilidade: Os modelos podem ser computacionalmente caros e exigir recursos significativos para treinamento e processamento.
- Implicações Éticas: A capacidade dos LLMs de gerar texto convincente pode levantar questões sobre a autenticidade, honestidade e privacidade.
- Diversidade de Aplicações: Os modelos devem ser capazes de realizar tarefas em uma variedade de domínios, desde tradução automática até geração de conteúdo.
Taxonomia de Modelos de Linguagem Grande
Aqui está uma proposta de taxonomia para categorizar os LLMs com base na escalabilidade, domínios de aplicação e implicações éticas:
1. Escalabilidade
- Básico: Modelos que podem ser treinados em computadores com recursos modestos.
- Médio: Modelos que requerem recursos moderados para treinamento e processamento.
- Avançado: Modelos que exigem recursos significativos para treinamento e processamento.
2. Domínios de Aplicação
- Tradução Automática
- Geração de Conteúdo
- Análise de Sentimento
- Conversão de Linguagem
3. Implicações Éticas
- Segurança: Modelos que são projetados para proteger a privacidade e segurança dos dados.
- Transparência: Modelos que fornecem transparência sobre suas ações e processamento da linguagem.
- Responsabilidade: Modelos que assumem responsabilidade pelas informações geradas ou processadas.
Exemplos de Modelos de Linguagem Grande
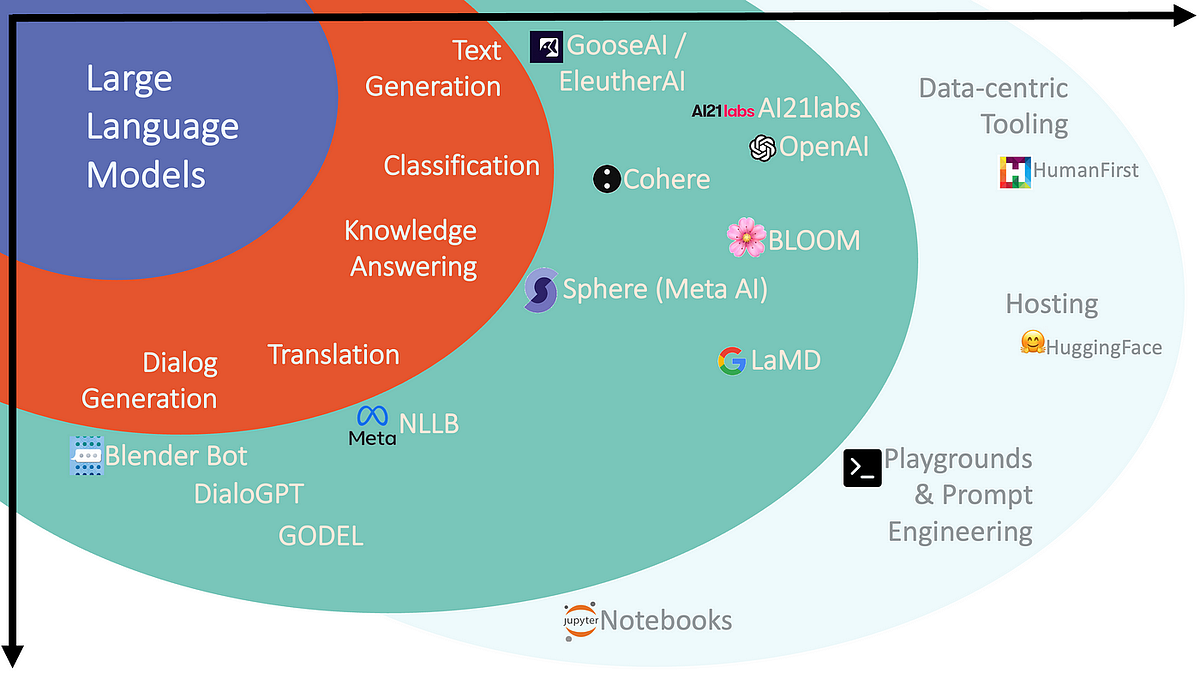
- BERT (Bidirectional Encoder Representations from Transformers): Um modelo de linguagem grande clássico que é amplamente utilizado para tarefas como tradução automática e análise de sentimento.
- RoBERTa (Robustly Optimized BERT Pretraining Approach): Uma versão melhorada do BERT que é projetada para realizar tarefas mais complexas, como geração de conteúdo e conversação.
- T5 (Text-to-Text Transfer Transformer): Um modelo de linguagem grande que é projetado especificamente para realizar tarefas de processamento de texto, como geração de respostas e tradução.
Conclusão
Os Modelos de Linguagem Grande são uma ferramenta poderosa para o processamento de linguagem natural. No entanto, é fundamental entender suas limitações e implicações éticas para garantir seu uso responsável. A proposta apresentada aqui oferece uma visão geral das arquiteturas fundacionais desses modelos e destaca a importância de categorizar e compreender suas características para aproveitá-los ao máximo.
Referências
Fonte: https://link.springer.com/article/10.1007/s42452-025-07668-w