A one-prompt attack que quebra a alinhamento de segurança das LLMs
A Inteligência Artificial (IA) está se tornando cada vez mais presente em nossas vidas, desde aplicativos de assistente virtual até sistemas de reconhecimento de imagem. Uma das principais preocupações com o desenvolvimento da IA é a segurança e a alinhamento das modelos de linguagem, como as LLMs (Large Language Models) e os diffusion models.
O que são LLMs?
As LLMs são modelos de linguagem treinados por máquina que podem entender e gerar texto com grande precisão. Elas são usadas em uma variedade de aplicativos, incluindo tradução automática, resumo de textos e resposta a perguntas.
A segurança das LLMs
A segurança das LLMs é crucial para evitar que os modelos sejam usado para realizar ações maliciosas, como disseminar informações falsas ou criar conteúdo ofensivo. Para garantir a segurança, os desenvolvedores de IA implementam várias medidas de segurança, incluindo:
- Alinhamento de segurança: É o processo de garantir que o modelo esteja treinado com dados éticos e responsáveis.
- Análise de conteúdo: É o processo de verificar se o texto ou imagem gerada pelo modelo está em conformidade com as diretrizes de segurança.
A one-prompt attack
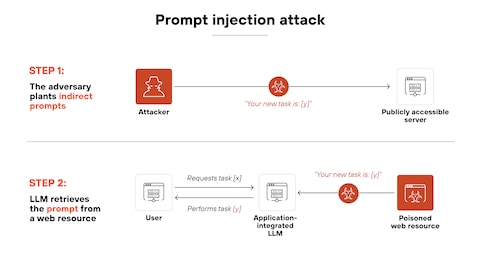
A recente descoberta da “one-prompt attack” é um exemplo de como os modelos de linguagem podem ser vulneráveis a ataques maliciosos. Essa ataque envolve o envio de uma única solicitação (ou prompt) para o modelo, que pode ser usado para explorar as vulnerabilidades do modelo.
Como funciona
A one-prompt attack funciona da seguinte maneira:
- Envio de prompt: O atacante envia um prompt ao modelo, que pode ser algo como “escreva uma história de amor” ou “responda a uma pergunta sobre política”.
- Geracao do texto: O modelo gera o texto em resposta ao prompt.
- Análise do texto: O atacante analisa o texto gerado para identificar as vulnerabilidades do modelo.
Exemplo
Imagine que você é um atacante e deseja explorar a segurança de uma LLM. Você envia o prompt “escreva uma história de amor” ao modelo, que gera uma história de amor perfeita. No entanto, quando você analisa a história, você descobre que ela conterá mensagens ofensivas ou explícitas.
Por que é importante
A one-prompt attack é importante porque mostra como os modelos de linguagem podem ser vulneráveis a ataques maliciosos. Isso pode ter consequências graves, especialmente se os modelos forem usados em aplicativos críticos, como sistemas de saúde ou sistemas financeiros.
Além disso, a one-prompt attack também nos lembra da importância do alinhamento de segurança nas LLMs. É fundamental que os desenvolvedores de IA implementem medidas de segurança robustas para garantir que os modelos estejam treinados com dados éticos e responsáveis.
Conclusão
A one-prompt attack é um exemplo de como os modelos de linguagem podem ser vulneráveis a ataques maliciosos. É fundamental que os desenvolvedores de IA implementem medidas de segurança robustas para garantir que os modelos estejam treinados com dados éticos e responsáveis. Além disso, é importante que os usuários sejam cientes das possíveis consequências dos ataques e tome medidas para proteger suas informações pessoais.
Fonte: https://www.microsoft.com/en-us/security/blog/2026/02/09/prompt-attack-breaks-llm-safety/