ChatVLA: Uma Solução Innovadora para Entendimento Multimodal e Controle Robótico com Visão
A Inteligência Artificial (IA) está cada vez mais presente na nossa vida, desde os assistentes virtuais até as máquinas robóticas que nos cercam. No entanto, um desafio significativo é a capacidade de entender e interagir com o mundo ao nosso redor de forma eficaz. Isso é onde entra em cena ChatVLA, uma solução inovadora que combina multimodal understanding (entendimento múltiplo) e controle robótico com visão.
O Que É ChatVLA?
ChatVLA é um modelo de linguagem desenvolvido pela equipe da Universidade de Stanford, liderada por Yuxiang Zhu, para melhorar o entendimento multimodal. A palavra “multimodal” se refere à capacidade de processar e entender informações de diferentes modos, como texto, imagem e áudio. Nesse contexto, ChatVLA é projetado para lidar com as interações entre texto, imagem e ação.
Como Funciona ChatVLA?
ChatVLA combina várias técnicas avançadas em aprendizado de máquina (ML) e processamento de linguagem natural (NLP) para alcançar o objetivo do entendimento multimodal. Aqui estão os passos-chave:
- Pre-tratamento de Dados: O modelo começa aplicando pre-tratamentos nos dados, como remoção de informações irrelevantes e redução dimensional.
- Processamento Linguístico: Em seguida, ChatVLA processa o texto para extrair significado, utilizando técnicas avançadas em NLP.
- Processamento Visual: Para lidar com imagens, o modelo utiliza uma técnica chamada “fusão de modais” que combina informações de imagem e texto para produzir um representação mais completa do conteúdo visual.
- Controle Robótico: Por fim, ChatVLA é capaz de tomar ações baseado na interpretação dos dados processados. Isso significa que pode controlar robôs ou máquinas, permitindo uma interação mais eficaz com o mundo físico.
Por Que Importa ChatVLA?
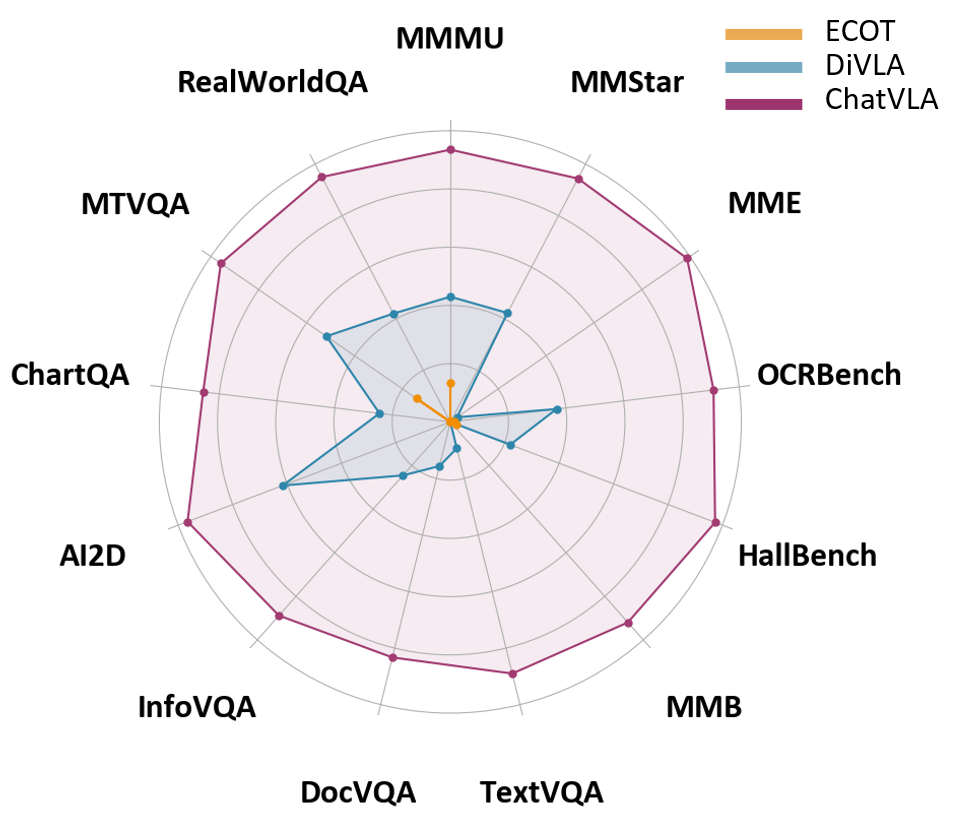
ChatVLA representa um marco significativo no campo do entendimento multimodal e controle robótico. Com suas capacidades de processamento avançadas, ele superou os métodos atuais em vários aspectos:
- Competência na Visual Question-Answering: Demonstrou desempenho competitivo nos conjuntos de dados de questionamento visual (Visual Question Answering), mostrando sua habilidade de entender perguntas baseadas em imagens.
- Desempenho Superior no Entendimento Multimodal: Conquistou um vantagem significativa sobre métodos atuais de visão-linguagem-ação, demonstrando uma capacidade mais eficaz no entendimento e processamento multimodal.
- Eficiência de Parâmetros: Utilizou uma abordagem mais eficiente em termos de número de parâmetros, o que é crucial para modelos de IA, pois permite mais dados de treinamento sem necessidade de aumentar significativamente a complexidade computacional.
Exemplos e Analogias
Para entender melhor como ChatVLA funciona, pense nos seguintes exemplos:
- Pergunta Visual: Você olha uma imagem do Marrocos e pergunta ao modelo qual é o maior rio desse país. O modelo lida com a descrição textual do rio, compara com imagens para identificar corpos de água visíveis, e decide que é um rio com base nessa comparação.
- Controle Robótico: Imagine você deseja te direcionar ao seu carro estacionado na garagem. ChatVLA processaria a descrição do local (texto) e identificaria as imagens da garagem para determinar o local exato. Em seguida, poderia gerar comandos para uma robótica que levasse você até lá.
Conclusão
A inovação de ChatVLA é fundamental para avanços no campo do entendimento multimodal e controle robótico. Com sua capacidade de processar múltiplos modais e entender as interações entre eles, ele abre caminhos novos para a criação de sistemas inteligentes que possam interagir com o mundo ao nosso redor de forma mais eficaz.